Benchmarks
LABS
Benchmarks for AI on real UI work
How frontier models copy, build and design UI.
Nov 16, 2026 · 3 benchmarks live · 20 models
Benchmarks3 live · 1 comingLeaderboard →
Copy Bench
14 models · 1,400 copiesGPT-6 Astra86.7

GPT-6.1 Sol82.2
Claude Fable 5.269.0

Design System Bench
14 models · 280 buildsClaude Fable 5.285.2
Gemini 4 Carbon82.9

GPT-6 Astra79.9
Turing UI Bench
12 models vs 12 designersTop designer4.7%
GPT-6 Astra3.4%
Median designer2.7%
Not run yet
Flow Bench
Coming soonDoes a model keep a product consistent past the first screen?
01 · Copy Bench
A browser check adds up to 12 points
Score / 100 · faded part = after the browser check
86.7
+9.8
GPT-6 Astra
82.2
+6.6
GPT-6.1 Sol
69.0
+6.6
Claude Fable 5.2
67.2
+10.2
Gemini 4 Carbon
64.5
+7.2
GPT-6 Sol
59.1
+9.0
Claude Opus 5.5
54.4
+9.0

Qwen 4 Max
51.9
+10.6

Muse Wonder 1.0
50.1
+8.9
Qwen 3.8 Max Prime
46.6
+12.0

Kimi K3.1 Pro
41.9
+8.6

MiniMax M3
39.2
+8.9

Grok 4.7
35.8
+7.7
Claude Sonnet 5.5
18.9
+2.5

MiMo V2.6 Pro
02 · Design System Bench
The top five sit inside one margin of error
% built from the product's parts · 95% interval
Claude Fable 5.2
85.2
Gemini 4 Carbon
82.9
GPT-6 Astra
79.9
Qwen 3.8 Max Prime
78.8
GPT-6.1 Sol
78.5
MiniMax M3
77.3
GPT-6 Sol
75.2
Claude Opus 5.5
73.7
Grok 4.7

72.7
GLM 5.3

71.5
Muse Wonder
69.7
Claude Sonnet 5.5
68.5
Kimi K3.1 Pro

68.2
MiMo V2.6 Pro
66.9
5060708090100
03 · Turing UI Bench
The best designer still beats every model
Pick rate in the feed · striped = designers
4.7%
Top designer
3.4%
GPT-6 Astra
3.3%
GPT-6.1 Sol
2.8%
Grok 4.7
2.7%
Claude Sonnet 5.5
2.7%
Median designer
2.6%
Claude Fable 5.1
2.6%
Muse Spark 1.3
2.5%
Gemini 3.8 Flash
2.1%
Claude Opus 5.5
2.1%
Qwen 3.8 Max
2.0%
GLM 5.3
1.8%
MiMo v2.6 Pro
1.1%
Kimi K3
1.1%
Lowest designer
Research
4 studies · built on 21st data
Nov 16, 2026Reward model
Can a model learn developer taste in UI?
Nov 2, 2026Turing UI Bench
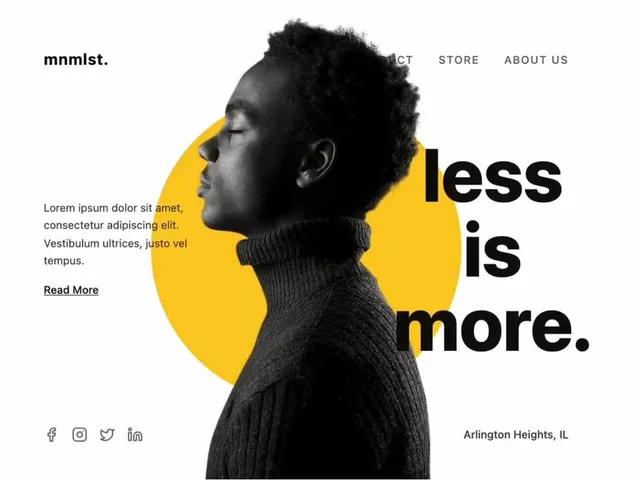
AI-made vs human-made hero sections, tested on real developers
Nov 2, 2026Taste
AI models predict which UI components developers choose, up to 70% of the time
Oct 27, 2026Animation
Can AI models rebuild an animation from screenshots?
21st Labs · partners
Test your model on real UI work
Private runs before release. Custom tasks from the 21st catalog.